短的结论:一片冰心在玉壶
基本情况:
Gemini 3.1 Pro 在 8 个月前也曾是一款旗舰模型,纯逻辑和视觉能力即便在 8 个月后的今天也依然不差,只不过 8 个月间其他对手模型的干活水平与日俱增,已经发展到可以组建数万 Agent 集群来攻坚一个目标的程度了。只靠 Flash 和 Lite 模型很难追上头部梯队,最终还是需要姗姗来迟的 3.1 Pro 真正继任者 Gemini 4 Argon 来缩小差距。
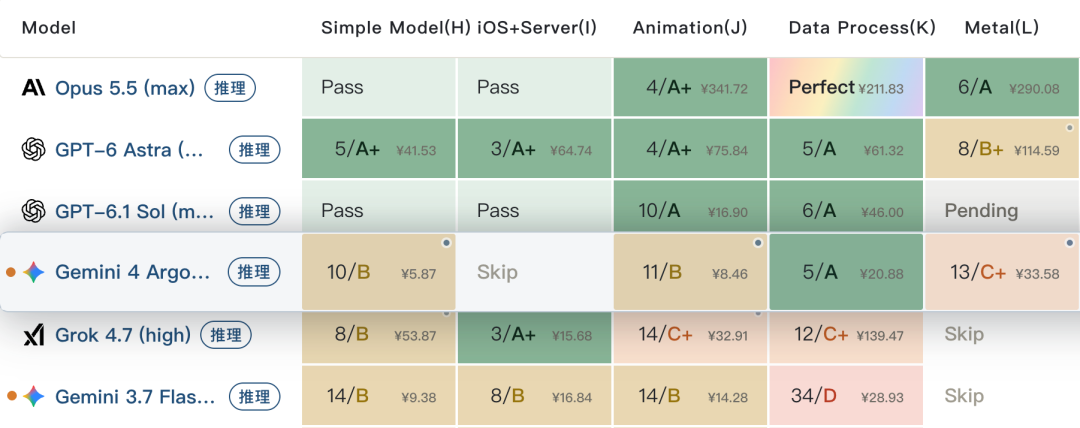
Gemini 4 Argon 的逻辑能力和 Agent 水平基本是同步提升,都来到了世界头部,但弱于 GPT 和 Claude 新旗舰的水平。Gemini 系列一向高效推理,这一次也没有拖后腿,平均 Token 开销保持在低位,结合限时折扣,综合任务成本低于对手旗舰。
逻辑成绩:
表格的排序切换为按中位分数降序。
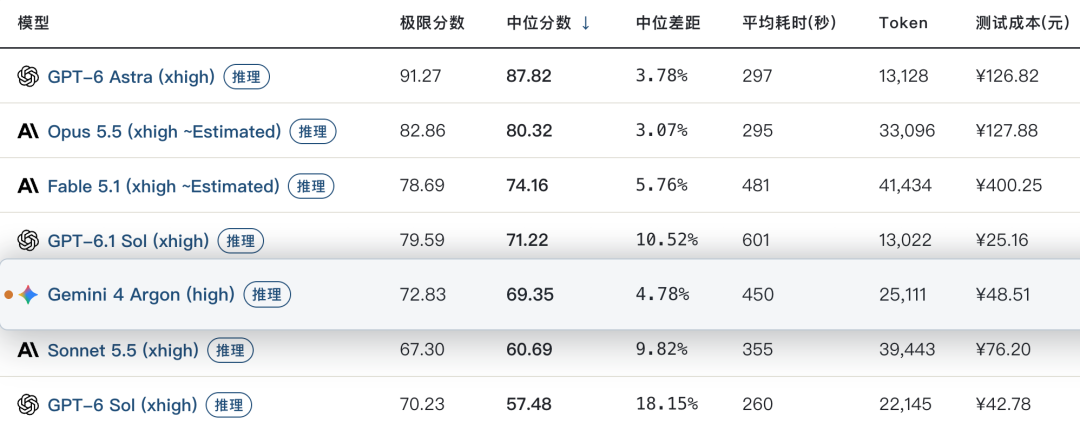
*1 表格为了突出对比关系,仅展示部分可对照模型,不是完整排序。
*2 题目及测试方式,参见:大语言模型-能力横评 26-09 月榜,增加#79、#80。
*3 完整榜单更新在 https://llm2014.github.io/llm_benchmark/
Agent 成绩:
-
编程表现:Gemini 4 的编程能力适应性强,在不同类型任务上有几乎相似的水平,优点和缺点也都很一致。由于 Gemini 专属 harness Antigravity 不支持配置三方 API,所以测试使用 OpenCode 进行(之前 Gemini Flash 也如此),以下结果可能会随 harness 不同而浮动,但模型体现的核心能力差异不会变化。
-
优点方面,Gemini 4 拥有极强的任务直觉,大部分任务都可以在一次长思考后,通过少数几次到十几次连续输出完成主要代码的编写。再通过少数几次验证达到交付状态。从结果来看,虽然 Gemini 4 验证很少,但任务完成度也很高,总体基本可用,但也有一些 Bug 是可以通过增加自测来规避的。而即便是有 Bug,Gemini 4 也可以在下一轮任务中完全修复,Bug 定位能力同样很强。
-
缺点方面,在测试的各个任务中,Gemini 4 的 UI 都存在马虎大意,比如使用了 UI 模板,但又没把模板占位删干净,导致控件重叠。又或者贪多,堆砌了大量 UI 元素,但管不好各 UI 的依赖关系等等。在前端审美上存在类似问题,整体风格独特,粗看十分精致,但离头部旗舰还有明显差距。
-
前面提到 Gemini 4 的验证少,而且开发动作干净,这使得 Gemini 4 成为了目前任务效率最高的模型,超过之前的 GPT-6 Astra/Sol,在大部分任务上,都比 GPT 短 30%以上。所以其Agent 任务成本也相当低廉,即便考虑到模型存在的缺陷,算上修复所需的消耗,也要比其他头部旗舰低 60%-90%。如果未来不再打折,也要低约 50%。这个成本虽然无法跟各家的 Flash 模型竞争,但如果是追求直出效果,则几乎别无选择。
-
复杂推理:Gemini 4 的推理能力比 Gemini 3.8 Flash 有显著提升, 与 GPT-6.1 Sol 基本持平,但互有优劣。在多轮连续推理上,GPT 显著更强更稳定。Gemini 则会会在轮次多,上下文上之后逐渐丢失目标和不遵循初始指令。极大解空间求解类问题也是 GPT 的强势领域,Gemini 还差一口气。而到了空间感知这种 Gemini 传统强项,得分就会逆转。但总体上Gemini 4 的推理能力和知识覆盖面都属于第一梯队。
-
幻觉表现:以 GPT 系列为标杆来看,Gemini 4 的综合幻觉水平并不高,但偶尔会有比较明显的硬伤,而且多 Pass 下会犯相同错误。前面 Coding 测试中的少量 UI 问题也和幻觉问题同源。幻觉的出现并不规律,没有明显任务聚集。
-
思维链:北美模型从始至终都是隐藏思维链,只提供浓缩摘要。但从 Gemini 4 起,他的思维链摘要换了风格,不再是对着原始输出,每若干段合并为一句话。变成了针对全文的大范围改写,使得摘要思维链同样具有极高可读性。这种改写式摘要丢弃了大部分试错和验证逻辑,只保留了推理主干和少部分踩坑反思。摘要逻辑连贯,重点突出,更像是模型对自己思考过程做的总结提炼。
赛博史官曰:
对 Google 这家穿越过互联网周期的公司来说,短期的困难并不可怕,路没有走偏,也没有走错,自己的护城河还在,模型的长板也足够长,短板也不算短。虽然追赶需要时间,但时间总是站在犯错少的一边。并不是模型要达到无可争议的第一才有用,有自己的生态位才重要。