短的结论:江海不择小助
基本情况:
上一次见到 Haiku 已经是一年前的 4.5,历史上从来没有单独给 Haiku 写过测评,是因为过去 Haiku 总是作为 Claude 家族的“附属”,随同其他大哥们一起面世。而随着北美进入价格战状态,对手已经拿出了足够的诚意,Anthropic 也不得不认真应对。在这种情况下 Haiku 也不再是可有可无的“摘要总结器”,而是要独自面对在低端任务场景的各种挑战了。
Haiku 5.5 各方面压制对手的 Luna 没有问题,但在这个 Size 下一些问题也不可避免。Claude 系列大体都要用更长的思考才能换来智力,而且模型 Size 越小,Token 换智力的“汇率”也越高。Haiku 工作在 xhigh/max 档位下非常容易耗尽 Token,即便没有耗尽,平均 Token 也相当高。所以虽然新 Haiku 的定价起步价只有前代 4.5 的 1/10,但在 Agent 工况下会很快触及高一档的计价,最终任务成本并不算低。
逻辑成绩:
表格的排序切换为按中位分数降序。
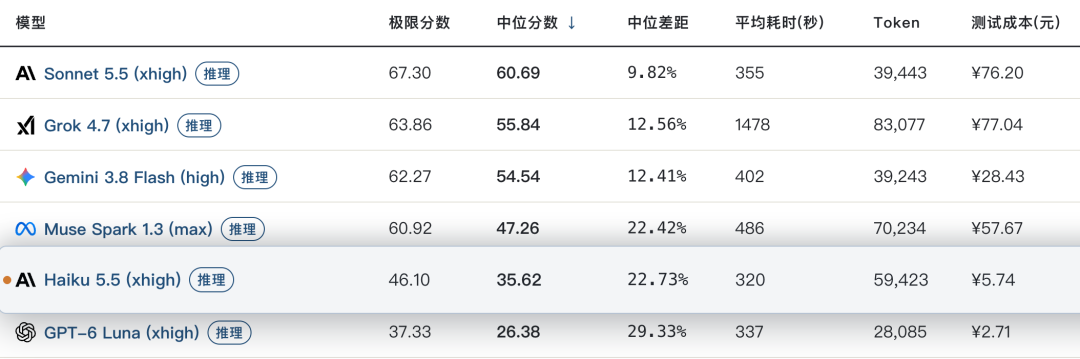
*1 表格为了突出对比关系,仅展示部分可对照模型,不是完整排序。
*2 题目及测试方式,参见:大语言模型-能力横评 26-09 月榜,增加#79、#80。
*3 完整榜单更新在 https://llm2014.github.io/llm_benchmark/
Agent 成绩:
-
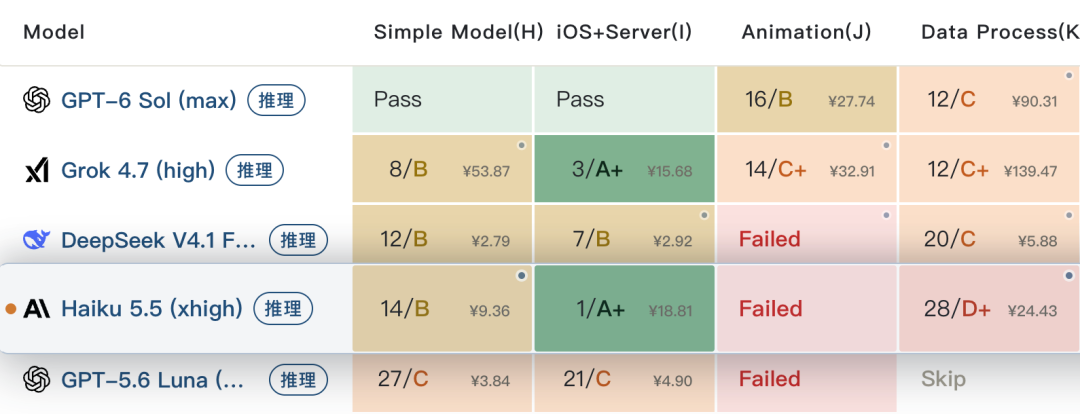
编程能力:需要先说明,Agent Coding 原本是测试各模型的最高档位,但 Haiku 在 max 档多次触顶,无法完成任务,因此统一降到 xhigh 档位来测。如果用 max 档,消耗会变高,但效果提升较为有限。
-
Haiku 在不同类型的任务上,表现差异很大,不稳定。比如在任务 I 这个各家模型表现都好,比较常规的任务上,Haiku 表现和前代 Opus 5 一样,可以拿到 A+。这种任务的特征是需求十分清晰,需求文档就是完整的任务清单,模型只需要对着清单逐一翻译成代码,再对着验收一遍,大致就能拿 A,不太需要额外思考。而一旦需要模型根据现实情况,常识,世界知识额外补充的情况,即便任务也很简单(比如 H),Haiku 表现也会大幅劣化。而这正是模型缺少世界知识的典型特征。
-
前端任务,Haiku 的功能完善度远大于美观度,几乎没有从 Sonnet/Opus 学到他们的高级审美。但只看功能的话,完成度还是很高,只要需求有提到的功能,基本不会遗漏。这一点是好过不少同梯队模型的。也再次证明了 Haiku 更擅长做路径清晰,不需要脑子的任务。
-
在问题定位方面,Haiku 有一定的技巧性,不会一条路走到黑。一次改不好,下一次会换方向再试。过程中也会充分利用搜索,不会自己死扛。但很多 Bug 原本可以在自测期间暴露,Haiku 因为自测不足,而错失了自己改正的机会。
-
单轮推理:Haiku 大体继承了Sonnet 的优势领域,在强上下文相关的领域,表现要更好,和 GPT-6 Luna 相比,相关任务 Haiku 基本都可以领先 Luna。但在对硬智力要求更高的任务,比如大空间解搜索,解路径优化等GPT 系列传统强项,Luna 则领先 Haiku。不过领先都是相对而言,实际上在相关任务上,两个模型都很难拿到满分,差别在于谁的思路更正确。
-
指令遵循:前面提到 Haiku 在 Agent 工况下有良好的指令遵循表现。但在纯推理场景,Haiku 会轻微的不遵循指令。但根据发生问题的场景推测,可能是 Haiku 为了兼顾日常对话,办公任务等任务而做出的权衡。为了输出的可读性,选择放弃部分输出约束。
赛博史官曰:
北美两巨头的旗舰模型和主力模型强归强,但出于市场竞争和模型梯队的考虑,小号模型也不会放置不管。两家的入门模型都被精确设计,刚好挡住同梯队的其他对手,又不会冒犯自家主力。但如果有的选,用户也很难把小号模型作为主力来用。这类模型更大的空间是在广大的自动化场景里充当那个被高阶模型自由调度的可信赖仆人。然而大风起于青萍之末,谁又能预料今天的小角色在接下来瞬息万变的战场上会不会是那个扭转战局的关键呢。