短的结论:日就月将,学有缉熙于光明
基本情况:
前面的 GPT-6 Sol 各方面更像是 5.6-Terra 的升级,能力勉强持平 5.6-Sol,做为大版本升级显然是不合格的。而现在的 6.1-Sol 才真正像 5.6-Sol 的继任者。6.1-Sol 虽然智力上限与 Astra 还有绝对的差距,但在干活方面还是基本继承了 Astra 的大部分能力。无论成品质量和审美,都如出一辙。
可见 OpenAI 与 Anthropic 不约而同的采用了同种策略,旗舰模型做全能,极致智力,再把其中与 95% 日常工作相关的能力单独提出来给次旗舰,这样次旗舰也可以用更低的价格提供差不多水平的服务,这是一种极佳的竞争思路。
逻辑成绩:
表格的排序切换为按中位分数降序
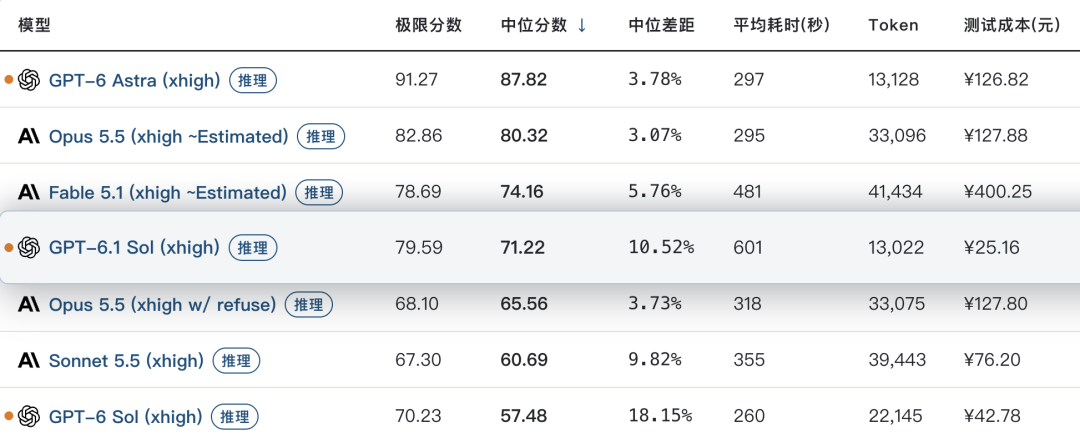
*1 表格为了突出对比关系,仅展示部分可对照模型,不是完整排序。
*2 题目及测试方式,参见:大语言模型-能力横评 26-09 月榜,增加#79、#80。
*3 完整榜单更新在 https://llm2014.github.io/llm_benchmark/
Agent 成绩:
-
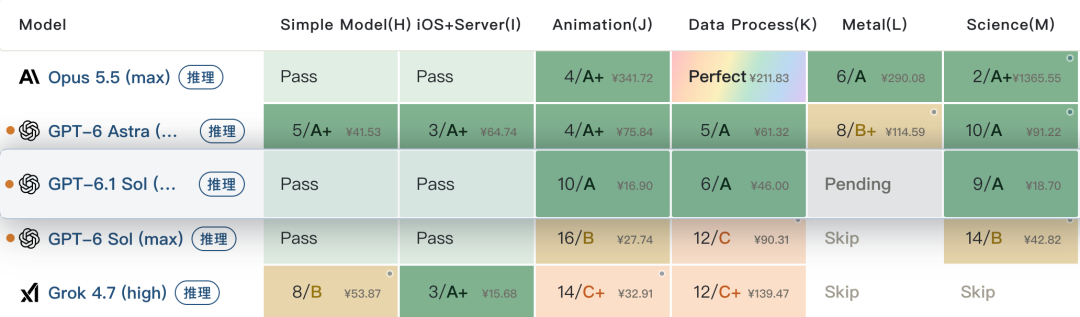
编程能力:前面提到,工作任务上,6.1-Sol 与 Astra 相差不多,但具体来看,二者有相似的错误,但不完全等同。相似点是在前端审美,主流技术栈使用方面,二者表现相当,Astra 会踩坑的地方,6.1-Sol 也无法避免。而 Astra 发挥小巧思的地方,6.1-Sol 也同样会灵光一闪。
-
而二者不同的地方在于,6.1-Sol 的细节失控更多。6.1-Sol 处处在模仿 Astra,而细节处的数值,交互行为,文字等,Astra 可以不经涂改一次成型,6.1-Sol 则只学到了形,而没有学到神,有些细节数值错一点,实际体验会错很多。任务 J 就很典型,6.1-Sol 多扣的分数,都来自细节。如果是真实任务,则是需要处理的数据,决策点越多,6.1-Sol 越不如 Astra。而简单的 0 到 1 任务,展示 Demo 等,二者则会差不多。
-
6.1-Sol 的成本不高,主要来自其 Cache Read 定价是 Astra 的十分之一,并不是因为其效率更高。相反,6.1-Sol 的任务效率(步数)往往比 Astra 多一倍以上。多出来的步骤主要是涂改和自测,同一个任务 Astra 大部分代码一次成型,Sol 则会在自测时多次修改。有些任务 Astra 甚至只自测几次就交付,自信满满。对 GPT 和 Claude 的模型梯队而言,通常是旗舰模型使用直觉和知识,争取一次成功,次旗舰增加更多自测来兜底,入门模型则大量自测来尽可能提升交付质量。虽然旗舰模型价格更高,但如果任务足够难,总成本反而是最低。这里的“难”指的是足够繁琐,或者需要专业知识,而不是单纯的任务规模大。
-
推理能力:6.1-Sol 在不同类型的任务上均弱于 Astra。不过有趣的是,绝大部分任务,而且的 Token 消耗是基本相同,只差十几 Token。而 Sol 找到的解数量,探索深度等均低于 Astra。比如新题#80,以 Astra 答案为满分基准,Sol Token 消耗几乎一样,但只能拿一半分数。可见思考越深入,回答正确率越高的规律在 Astra 和 Sol 这两个兄弟模型上并不成立,OpenAI 还在推理输出以外的环节控制了智力投入度。除此之外,Sol 的推理稳定性也要差于 Astra,即便 Sol 偶尔能有一次拿到和 Astra 一样的答案,也无法稳定复现。
-
幻觉:Astra 的幻觉水平十分优秀,6.1-Sol 无法与之媲美。在信息密度越高的场景下,6.1-Sol 的幻觉也越高,这与文本长度没有关系。前面提到的 Sol 在编程细节处理上的问题也源于此处。
赛博史官曰:
对于北美双雄而言,每发布一个模型,手里都有模型的下一代在待命,这样在商业对战上才有出招和变招的空间。不过在模型商战之外,两家也在思考未来的模型应该是什么样,并且给出了不同的答案。Anthropic 希望让模型严格恪守规范,做一个严谨的,有据可循的模型。而 OpenAI 则要把超级智力走到底,只要对上一个模型见过的任务进行彻底的学习,下一代自然就能表现的更熟练和睿智。一个领域已经没有新鲜任务,则通过给模型注入新能力来开辟新的用途,让更多人也参与到贡献任务数据中来。把这条路径贯彻下来,就得到了如今的 Astra 与 Sol。