短的结论:好风频借力,送我上青云
基本情况:
当北美两巨头沉默了一段时间,那可要警惕了,这通常不是他们碰壁了,或者主动减速了,这表明他们正在研究一些惊人的东西。而其中一家一鸣惊人之后,另一家也必然不甘落后,只会报复性更新,鸣叫的更大声。这种孩子气似的竞赛支撑着大模型头部竞赛演进到现在。
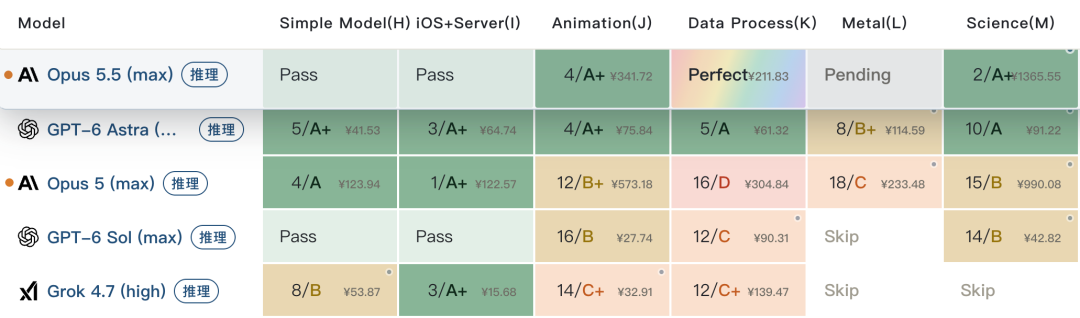
就像上次 Opus 5 对阵 GPT-5.6,输了推理但赢了 Agent。这次 Opus 5.5 对阵 Astra 则是推理输得不多,但 Agent 全面领先。不过 Opus 特有的严谨验证拉高了其交付成本,这方面还是 Astra 的高密度智力碾压流派更胜一筹。
逻辑成绩:
表格的排序切换为按中位分数降序。
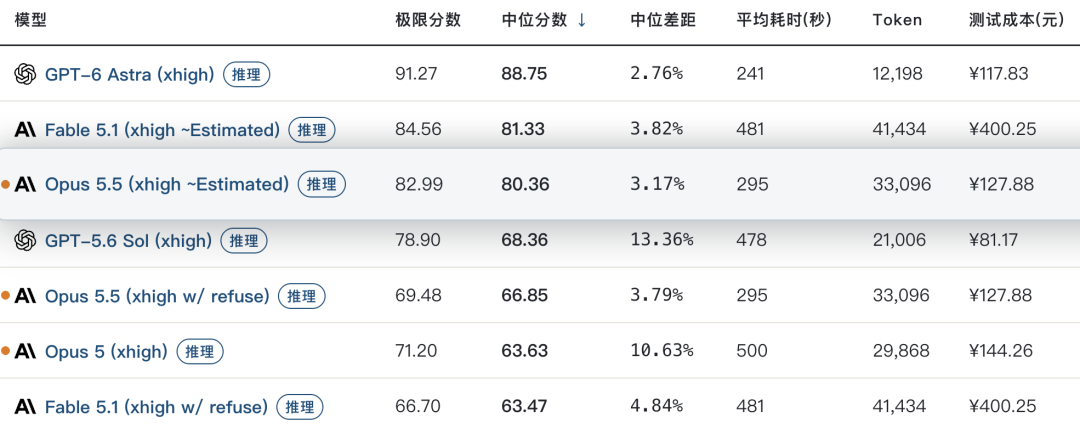
*1 表格为了突出对比关系,仅展示部分可对照模型,不是完整排序。
*2 题目及测试方式,参见:大语言模型-逻辑能力横评 26-08 月榜,增加#76、#77、#78。
*3 完整榜单更新在 https://llm2014.github.io/llm_benchmark/
Agent 成绩:
-
编程任务:如果 Astra 在常规演示型或者 MVP 性质的 Coding 任务上已经算毕业水平,那么 Opus 5.5 则在真实生产和线上交付型任务上也往前推进了一大步。更直接的说,如果没有特殊且复杂的要求,Opus 5.5 的产物几乎可以放心的直接投入线上生产环境。
-
这种表现主要来自 Opus 系列一直坚持的工程素养和流程规范性,Opus 5.5 的主要流程和验证深度大致和前代 Opus 5 相同,只多不少。但 Opus 5.5 会额外再进行反思,Opus 将每个任务当做需要正式上线,接受用户的严肃任务,在工程主体完成后还会持续的思考每个工程细节是否完善,最多情况反思部分可能会占到全部流程的 20%,比如项目 M。最终交付产物不但会达到相应的生产标准,Opus 有时还会贴心的考虑好后续发展方向,给自己留下后续规划文档。不太严谨来说,Opus 5.5 目前的许愿能力已经十分接近自迭代。
-
Opus 5.5 也十分擅长利用外部资源,这与 GPT Astra 是较为相似的,二者都非常会搜索和使用各种生僻的三方资源站。有这些外部资源加持,也让 Opus 的交付可用性显著高于前代,也高于纯靠大力出奇迹的 Fable。可见模型并不需要自己背会所有数据,灵活借力,活学活用也是提升能力的关键。不过这也说明模型已经意识到自己身处在一个资源丰富的巨大网络世界,不再是被困在一台算力服务器里的孤立灵魂。
-
前面提到 Opus 5.5 的自测比例极高,但这不代表 Opus 的直出能力很低,需要靠测试来修复问题。相反,如果完全不自测或者少自测,其交付完成度也不低,比如在下项目 K,其任务消耗比前代更低,步骤也更少,原因在 Opus 仍然不会调用鸿蒙的自测工具,但不妨碍 Opus 写出满分代码。从任务断点看(进入测试过程之前的代码 snapshot),如果完全禁止 Opus 自测,各个项目的完成度已经相当高,不存在致命问题,只有少量细节考虑不周,如果按分档来看,依然可以拿到 A,但任务消耗会减半。但这依然高于 GPT Astra。
-
推理效率:Opus 5.5 的推理效率大体持平前代,略高一些,但配合 API 降价,平均推理任务成本要比前代更低。如果跟标杆 GPT Astra 比,则所有任务的消耗都比 Astra 更高。而且 Opus 5.5 在少量巨大解空间任务上也会耗尽 Token。如果开到 max 档位,这种情况只会更多,因此不推荐在非 Agent 场景下开到 max 使用。
-
复杂推理:与 GPT Astra 相比,Opus 5.5 主要丢分任务几乎都是解空间探索类型任务。GPT 可以在较短 Token 内尝试更多可能性,探索范围更大,因此能找到更多解或者更深入的答案。而 Opus 则会停在一个 80 分方案,这与其在 Agent 工况的表现大相径庭。说明 Opus 的训练数据依然是任务主导的,与 GPT 的智力主导并不相同,但殊途同归,两个模型都是目前推理能力顶峰。
-
安全限制:Opus 与 Fable 一样有安全限制,而且安全分类器一样存在错判,先前的 Fable 5.1 测试遇到了 5 次拒答,而 Opus 则遇到了 3 次。3 个题都是比较老,即将淘汰的题目,只是因为题面看起来像在破解密码而被错判,令人哭笑不得。这 3 题前代 Opus 5 都拿过满分,同级别模型也基本都可以满分,因此使用了 Opus 5 的分数来估算 Opus 5.5 的总分是合理且置信的。
赛博史官曰:
北美两大家都有自己的发展主线和优先级,OpenAI 坚持少即是多,短就是好,点到为止。而 Anthropic 坚持严谨和规范,永远比用户多想一步。GPT 像一个敏捷的行动派优等生,而 Claude 则像一个无微不至的大管家。当模型的智力已经过线,用户偏好哪一家的模型也就带上了个人的性格偏好。没有意外的话,第一个自迭代持续进化的模型也会在二者之间诞生,那时候两位模型又会如何评价自身和他的用户呢。