短的结论:鼎之轻重或可问也
基本情况:
马斯克的高频迭代,快速改进理念正在 Grok 身上大显神威,从 Grok 4.5 发力以来,3 月迭代 3 版。在这个每月都有 10 余款模型迭代的环境里,综合排名还在稳步上升,可谓来势汹汹。如果未来 Grok 4.8 乃至 5 能一举突破 OA 两家对头部的封锁,也并非不可能了。
综合性能来看,Grok 的逻辑和多轮能力基本对应,没有偏斜。只不过代价偏大,最终任务成本并不便宜,即便在北美阵营的同档位中,也属于偏贵。
逻辑成绩:
表格的排序切换为按中位分数降序。
需要注意,测试 4.6 使用了 high 档,本次使用 xhigh 档。
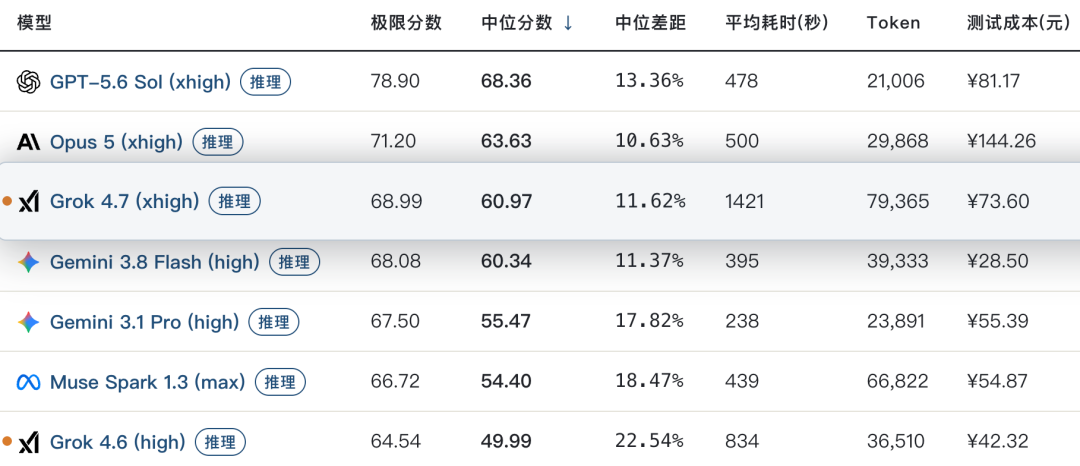
*1 表格为了突出对比关系,仅展示部分可对照模型,不是完整排序。
*2 题目及测试方式,参见:大语言模型-逻辑能力横评 26-08 月榜,增加#76、#77、#78。
*3 完整榜单更新在 https://llm2014.github.io/llm_benchmark/
Agent 成绩:
-
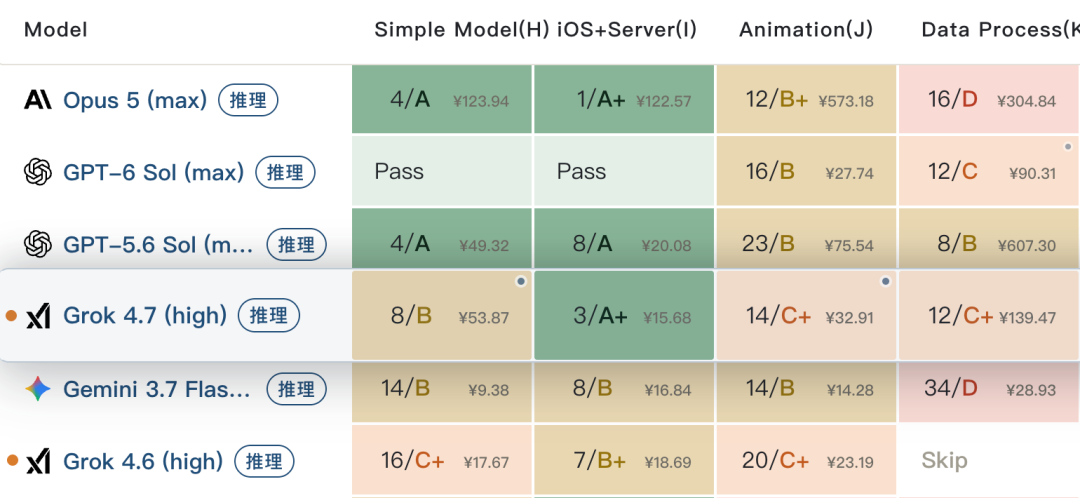
编程任务:Grok 4.7 相对 Grok 4.6 在编程任务上的改变有好有坏。其中前端审美,布局,配色等容易被看见的方面,4.7 比 4.6 略有提升,整体瑕疵和小错误更少,但还是很粗糙,生硬。放在同梯队模型里,依然算不够好看的一类。但好的方面是,Grok 4.7 学会了充分自测,从最早 Grok 4.5 完全不自测,到 Grok 4.6 会做基本编译自检,再到 4.7 能完整闭环的调模拟器和写用例,3 个月以来 Grok 成长显著。但 4.7 对常规网页前端的自测水平并没有保持到其他技术栈,比如做项目 K,Grok 也坦言自己不会自测,请用户自行测试。即便给提示(测试任务之外),Grok 也做的不熟练,泛化能力欠佳。
-
幻觉抑制:Grok4.7 在幻觉上表现突出。之前 Grok 4.6 还会在短文本上偶现一次幻觉失控,中长文本则大幅滑落到低可用区间。Grok 4.7 明显改善,只剩少量复杂文本还做不到像 GPT, Opus 那样的信息理解和提取精度,但表现也在第一梯队。不过这类任务也是 Grok 4.7 消耗 Token 最多的类型,平均开销达到了 90-150K,大幅拉高了其平均 Token 用量。
-
复杂推理:综合来看,Grok 4.7 在复杂多步推理上的改进,并没有像其他任务那样大。处在有增有减,效率不变的状态。比如解空间压缩,4.7 可以在 Token 消耗量基本不变的情况下,得分率略高。或者花费略多 Token 做更多分析,但反而错过了正确答案。越需要解题技巧,不能靠暴力的问题,Grok 4.7 的表现反而更低,换言之,原本 Grok 4.6 具备一定的解题直觉,而 4.7 更多使用暴力。下个月换题后,4.7 分数可能会降低。
赛博史官曰:
对于两超多强的格局而言,在硬件充沛的情况下快速追近是不难,但要弯道超车却很不容易,只要头部阵营不犯错,下位者难有机会。但随着北美竞争者入局,头部也开始逐级设防,降价保量了。这通常会形成胶着竞态,一如正发生在中国的情况一样。但老马并不这么认为,如果他点燃由百万卡集群组成的发动机主引擎,加速到第二宇宙速度,冲到月球,冲向火星,为什么不可以呢。