短的结论:五岳寻仙不辞远
基本情况:
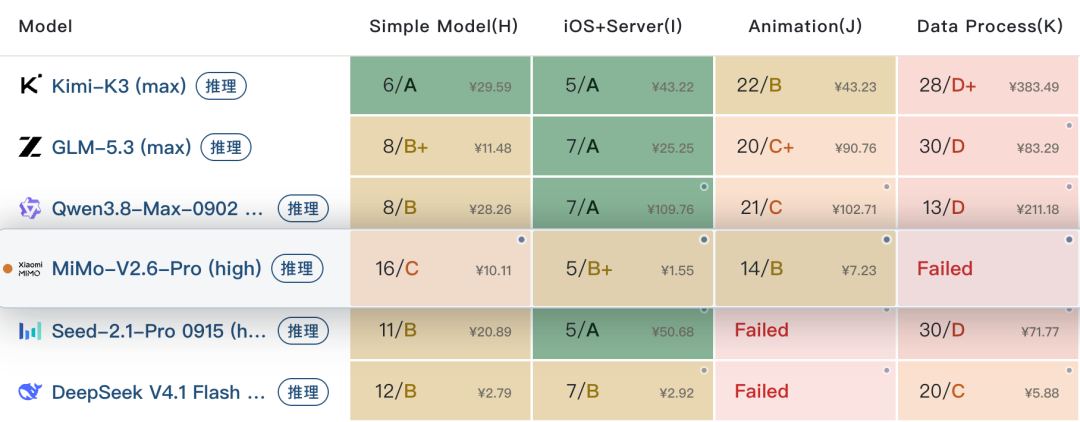
MiMo 的上一次迭代已经要追溯到 5 个月前了,在 V2.5 这一代,其 Agent 能力在同期模型中不算领先,但因为足够便宜和快,在一些个人场景还是有发挥空间。而 V2.6 则是大幅补上短板,在保持低价和快速的同时,综合能力也进入了同期的中位区间,实用性显著。
MiMo-V2.6 Flash 和 Pro 都支持最大 128K 输出,但逻辑测试中,Pro 有多达 59% 的任务都超出最大长度,Flash 也有很高比例。所以都没有办法测出可比分数,因此这部分暂缺。
从部分有效数据能看到 Pro 和 Flash 的平均 Token 消耗达到了 89K 和 91K,超过之前 DeepSeek V4.1 Flash。
Agent 成绩:
完整榜单:https://llm2014.github.io/llm_benchmark/#category=code_v3&dataset=code_v3%7C2026-09%7C0
以下只分析其 Agent 编程表现:
-
综合来看,V2.6 能较好的理解各类型任务,具备不同技术栈的基本知识,不理解的技术和知识点也会大量动用搜索,临时学习,并且学习效率很高。比如项目 J 本身会要求大量搜索,V2.6 总共 95 次搜索,在所有模型中也属于次数较高的。并且 V2.6 结合搜索结果,最终产物完成度较高。不过临时搜索不能取代自身知识,部分任务中,由于自身知识局限性带来的直出代码问题过多,拖累了整体表现。
-
在审美方面,V2.6 表现较为独特,与其他国模差异较大,自成一派。整体美观度而言,V2.6 有足够可用性,可满足一般交付。但 V2.6 对功能性的看重大过美学,很多场景布局、UI、功能分区等,都是美学让位。导致了按功能来看,交付物是没有问题的,但如果只看截图,会得出相反结论。在前端复杂任务,这种倾向则尤为明显,V2.6 甚至为了满足原始指令要求的各项细节,而完全放弃可交互性,背离用户真实诉求。
-
V2.6 完成任务的效率总体上较高,在国模中处于领先位置。在首轮直出代码或者 0 到 1 工程中,通常不会过度自测,比如前端项目,只会验证部分主功能点,后端任务使用的单测用例数量也很保守。而且中低难度任务,V2.6 较少在自测期间反复涂改代码,也节省了很多步骤。比如在项目 I 这类任务,V2.6 就可以用较低成本实现。而 V2.6 在bugfix 和功能增补环节,则表现出完全不同的行为,更容易陷入自测地狱,会想办法把问题复现出来再动手改,如果一次复现不了,就多复现几次。还复现不了,就联网搜索类似问题的解决思路。表现很像人,但效率很低。通常要定位十几轮之后才会动手实际修复,这与一些顶级模型靠直觉就立刻感知到潜在问题点的表现还有很大差距。
-
一体两面的是,V2.6 在首轮中的保守自测,会留下很多隐患,V2.6 不具备像 GPT 那样一次性把代码写对的能力,这在目前所有在测任务中都有体现。或许在最开始就要求 V2.6 做严格自测,可以减少返工,让最终的整体交付时间更多。这部分对比测试笔者尚未完成,有兴趣读者可自行探索。
赛博史官曰:
山在哪里,登山的人就去哪里。登上山的人,也就成了更高的峰。对于这场永远在路上的旅程,总会有不同的人尝试不同的路,他们分散在茫茫林海,着眼于自己的步伐。有的时候会有人振臂一呼,宣告一个新的里程碑,脚步踏入前人未至之境。那里不一定离峰更近,但探索未知却弥足珍贵。