短的结论:会当凌绝顶
基本情况:
OpenAI 长期奉行压缩即智能,在包括 Anthropic 在内的一众模型团队都在通过加长思维链,增加更多 Agentic 步骤来提升交付效果的同期,OpenAI 却一直在坚持用更少 Token,更少步骤来达成任务。在 GPT-5 到 GPT-5.2 时期,都是出了名的写完代码不验证,直接交付,而同期的 Claude 却可以在严谨的验证下交付完成度更高的产物,这导致用户长期偏爱 Claude 而轻 GPT。
对此 OpenAI 选择一条路走到底,这条路的第一个里程碑是 GPT-5.6,做到了效果持平行业头部,但消耗和成本轻微更低。而如今则来到了另一个里程碑,效果远超行业头部,消耗远低于行业头部。
逻辑成绩:
表格的排序切换为按中位分数降序。
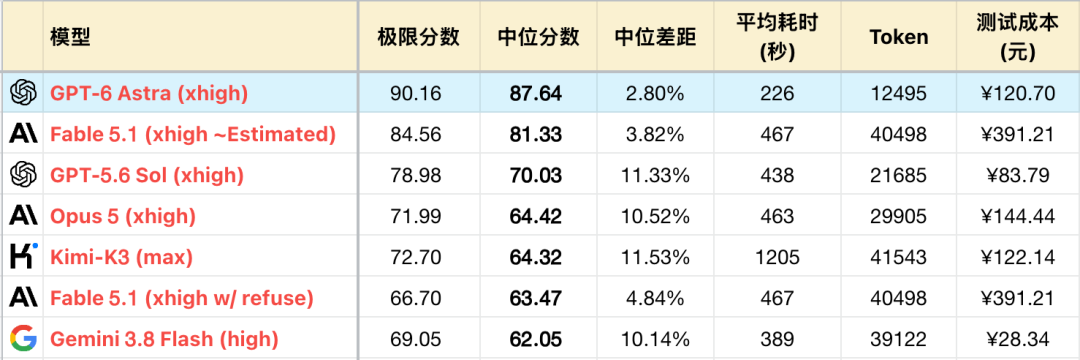
*1 表格为了突出对比关系,仅展示部分可对照模型,不是完整排序。
*2 题目及测试方式,参见:大语言模型-逻辑能力横评 26-08 月榜,增加#76、#77
*3 完整榜单更新在 https://llm2014.github.io/llm_benchmark/
*4 红字模型代表工作在推理模式下(慢思考),黑色模型则是对应的非推理模式(快思考)
Agent 成绩:
-
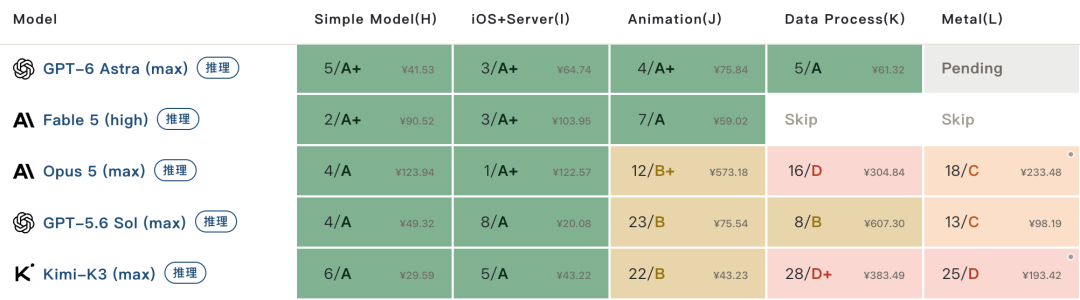
编程任务:GPT-6 的编程能力全面超过上代 GPT-5.6,而且在定价高2.5 倍的情况下,任务实际成本甚至更低。任务成本基本上只跟 Cache read 定价和步数相关,而 GPT-5.6 的任务完成效率(步数)已经很优秀,GPT-6 并没有更短。但 GPT-5.6 会消耗更多成本在后续 Debug,而 GPT-6 基本可以一遍做好(在需求足够明确的前提下),这就抵消了 GPT-5.6 的价格优势。项目 K 就是典型的情况,GPT-5.6 在同一个 Bug 上反复定位,造成巨大 Token 消耗,而 GPT-6 一遍过,拿高分的同时,成本控制得极低。
-
其中改进最显著的一点是,GPT-6 更擅长综合运用各种资源完成任务。比如项目 H,需要进行简单建模,提示词从来没有禁止用外部素材,但此前所有模型在 Coding 状态下都会自觉的自己画一切模型和纹理。而 GPT-6 则毫不犹豫的找三方网站下载贴图素材,这使得 GPT-6 的产物超越了所有模型,达到照片级。同样还有项目 J,GPT-6 也会照着历史资料做动画,而不是像之前模型只是基于碎片的历史信息自己从头脑补画面。不过 GPT-6 的另一个特征是有参考图他真参考,而不是只看个大概。同样是项目 J,GPT-6 成品的还原精度是目前最高独一档,一些精细部位,纹理,运动机制等都精确还原,达到了这个项目的毕业水平。
-
GPT-6 基本改掉了在 UI 上写调试信息的习惯,但克制不足想把 UI 塞满的冲动。只要没有约束,GPT-6 会想办法在各个空白处写上 AI 味很浓的文案。这样的内容会让 UI 看上去完整,但经不起细看。
-
GPT-6 主要失误在于会忽略长需求中仅有几个字的细节要求,这种情况在多个项目中都有出现。但需要说明,测试项目的 Prompt 都是长达 3000 字的完整Spec 文件,如果是更短的功能要求,甚至一句话需求,则不会遇到这类问题。而且对于一句话需求,GPT-6 处理也较为克制,不会额外做太多发挥。
-
低幻觉:GPT-6 的上下文幻觉来到一个新的水平,显著低于其他所有模型。在长文本任务中,GPT-6 的文中细节检索精度和 Fable-5.1 同级,但可以稳定保持,而 Fable-5.1 还会出现 3Pass 输出 3 种答案的情况。部分长文任务 GPT-6 表现低于 5.6,但主要原因是 GPT-6 更保守,不愿意做超出文本太多的猜测,从而错过了正确答案。但也反而说明 GPT-6 的幻觉抗性更好。
-
推理效率:前面已经提到 GPT-6 拥有极高推理效率,具体而言,在很多中高难度任务上,如果让人类来解答,并把自己的思考过程逐字记录下来,最终的字数可能会高于 GPT-6 (按 1Token = 2 汉字折算)。如果使用更低的推理强度,GPT-6 仍有正确率,而 Token 消耗还会显著更低。不过跟前代 GPT-5.6 比,则 GPT-6 并非所有任务都有更高效率,在需要更精细指令遵循的任务上,GPT-6 消耗不低于 GPT-5.6。
赛博史官曰:
过去近 4 年的大模型发展史,已经出现了多次用户预期过高-> 模型达不到预期 -> 不过如此 -> 模型超出预期的循环。正是这种许愿-兑现循环推动了大模型持续发展,23 年的用户不会把自己的核心代码库全权委托给 AI,而如今的前沿模型可以毫不费力的兑现程序员的一切愿望。前沿团队总是能发现下一个许愿池,那是因为他们站的够高,普天之下,一览无遗。