短的结论:天高任鸟飞
基本情况:
技术上的成功和商业上的领先,让智谱能以自己的节奏推进版本,2 个月,就是智谱一个版本的间隔。两个月前的 GLM-5.2 曾经是国产阵营第一个冲进高可用梯队的模型,这个位置一坐就是 2 个月,直到 被 Kimi K3 超过。K3 让用户直观感受到超大 Size 模型能带来怎样丰富的知识和审美,而 GLM-5.3 则重新证明,至少在做好编程这件事上,并不需要太大 Size和太高成本,让多数人用得起仍然必要。
推理能力的升级不算激进,一部分是更长更深入的思维换来的。但编程能力的提升确是实打实的,任务成本甚至没有比 5.2 更高。在当前 DeepSeek 已经涨价的背景下,5.3 就是性价比之选。
逻辑成绩:
表格的排序切换为按中位分数降序。
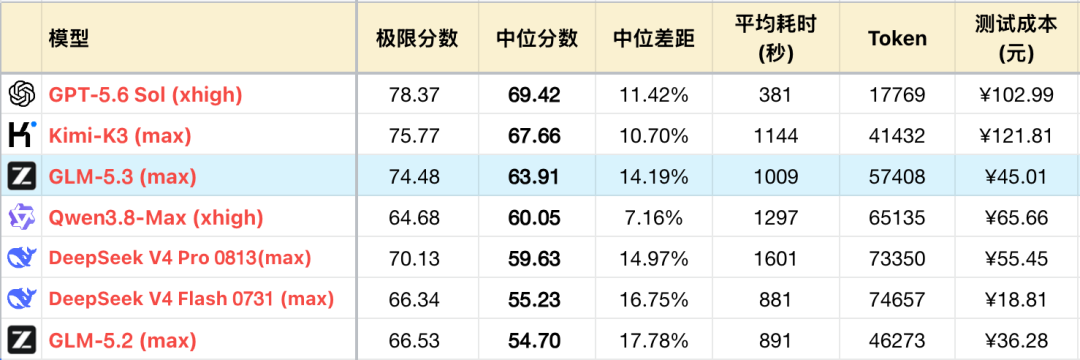
*1 表格为了突出对比关系,仅展示部分可对照模型,不是完整排序。
*2 题目及测试方式,参见:大语言模型-逻辑能力横评 26-07 月榜 ,增加#74、#75
*3 完整榜单更新在 https://llm2014.github.io/llm_benchmark/
编程 Agent:
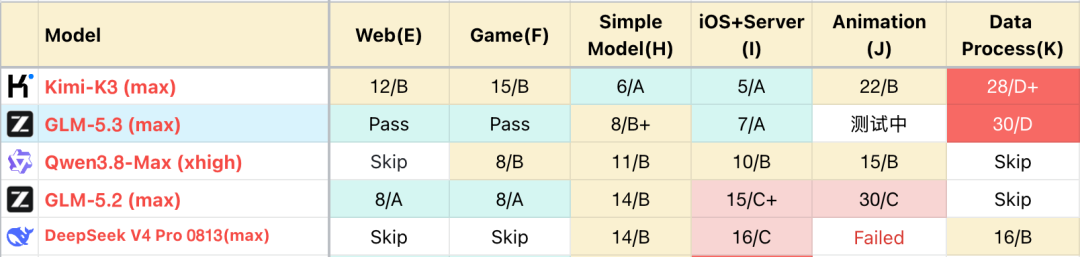
*1 测试方式参见:大模型编程应用测试-V3榜单
-
编程:GLM-5.3 总体上十分接近 K3,甚至在一些简单场景,二者几乎无差。GLM-5.3 主要差在整体审美和边缘知识。
-
GLM-5.3 的开发效率很高,任务平均步数不多于 K3 或同级别的Qwen3.8、Gemini 3.7 Flash 等,最好情况GLM-5.3 只使用 Qwen3.8 一半的步骤,并且效果更好。其他模型多花的步骤主要在于自测,而GLM-5.3 自测偏少,而且更偏好并发调工具。最终GLM-5.3 的同任务成本只有 K3 或 Qwen3.8 的 1/3 ~ 1/2。
-
GLM-5.3 对边缘知识的掌握程度有断崖式下降,比如同样功能做成前端形态则会充分使用各类辅助手段,而换成鸿蒙版本则连基础的静态检查都不使用。而对于依赖世界知识的场景,GLM-5.3 也需要进行更多的搜索或者阅读三方库源码才能下手。这带来了很大不确定性,需要用户针对自己场景,进行一定的场外知识补齐。
-
一些项目 GLM-5.3 虽然与 K3 最终得分相近,但 K3 一般是交互细节不尽人意,而GLM-5.3 则存在随机忽略原始要求导致功能遗漏,性质上更严重一些。而 K3 的大量自测很大程度上兜底了这类问题。
-
推理能力:GLM-5.3 在大部分任务上,推理能力没有强过 K3,尤其对上下文召回有较高需求的场景,GLM 几乎都弱于 K3。而 GLM 偏高的 Token 输出量也加大了产生幻觉的概率。K3 的弱势项目,像空间推理,直觉求解等,GLM 也没有办法做的更好。个别 GLM 得分更高的任务主题较为分散,并且领先幅度不大。
-
推理效率:从前面统计表可以看到,GLM-5.3 较前代上涨24%,超过了性能的提升幅度,平均用量在全部模型中排在DeepSeek 系列和 Qwen 系列之后,已经属于低效区间。而且GLM-5.3 最大 128K 的输出长度,也进一步限制了 max 档位的实用价值。测试中有少量题目因为耗尽输出长度,而被迫降级到 high 档进行测试。但这没有影响其极限分数。不过在 Agent 任务场景,GLM-5.3 在 max 档位也不太容易出现像 DeepSeek 系列那样的超长推理起手,相近规划先行的情况,最终消耗并不高,全程 max 是可行且实用的。
赛博史官曰:
国产算力成本居高不下是一个客观事实,单纯的放大模型尺寸来求取性能固然可行,但并不经济。在现在时间点理性的商业决策应该是智谱这样进一步提升模型智力密度,打破对中尺寸性能天花板的固有认知。当然,不顾一切追求智力上限也是必要的,而智谱则让其他的选择也不被忽视,如此幸甚。